
全景鋪完,講留言、庫存那些戰役之前,先把當年的武器庫攤開——因為後面每一章的取捨,都是在這套技術棧的邊界裡做的。團隊很小:3 個後端、3 個前端,偶爾發包給外包 1–2 位工程師。武器庫也很樸素:PostgreSQL、Django(API + WebSocket)、RabbitMQ、Redis、Celery,全套跑在 GCP 上。這篇要回答兩個問題:為什麼是這五個,以及——小團隊跑得快的原因,其實不在技術棧上。
這五個元件不是隨便湊的。回頭看,它們剛好是每一種時間尺度各請一位專家:
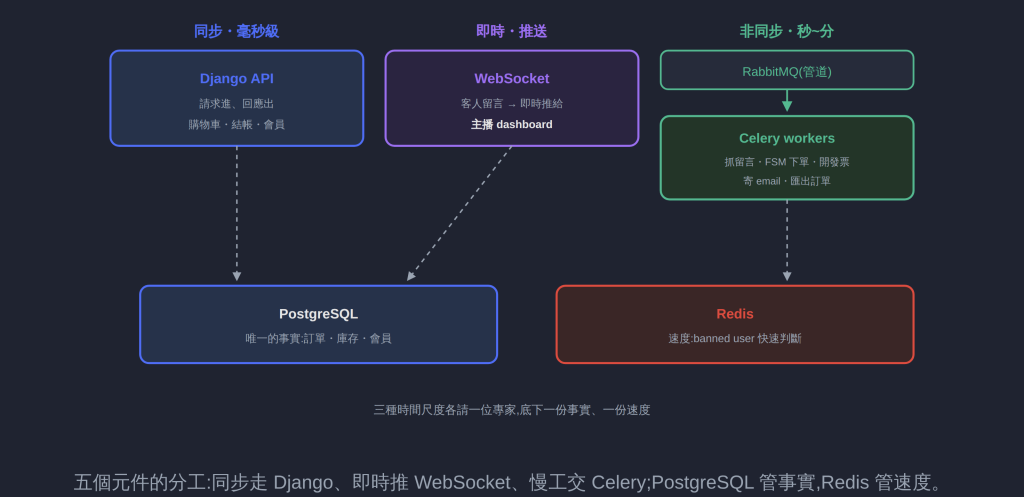
幾個分工的細節,比圖上多講一點:
技術棧樸素,但 pipeline 很完整——這才是當年真正的競爭力:
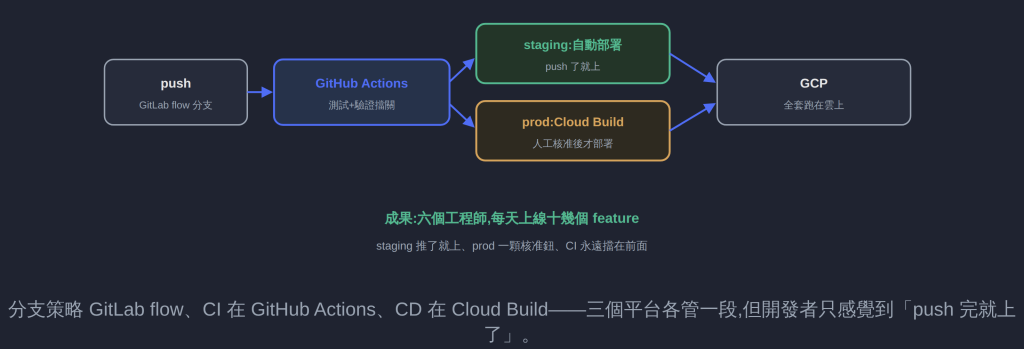
流程只有三句話:push 之後 GitHub Actions 跑測試與驗證;合進 staging 分支就自動部署,想試什麼推上去馬上看;要上正式環境,推 prod 分支、到 Cloud Build 按一顆核准鈕。staging 零摩擦、prod 一道人閘、CI 永遠擋在最前面——就這樣,六個工程師的團隊每天可以上線十幾個 feature。
我後來的結論是:技術棧決定你能做什麼,CI/CD 決定你做多快。 boring tech 誰都會選,但同樣五個元件,有的團隊一週上一次版都心驚膽跳。差別從來不在元件,在 push 到上線之間有多少人工步驟——每多一步,疊代就慢一截,而小團隊唯一的優勢就是快。
這是我想了很久之後的誠實答案:這五個元件,重來一次我全部保留。 最大的理由是 Django admin——它的地位幾乎無可取代,但角色要講清楚:admin 只給工程師用。它是工程師的安全操作台——比直接對 DB 下 SQL 安全得多,設定 Celery 排程、處理各種花式的一次性需求,註冊個 model 就有介面;營運和客服的介面則是自建的(這個團隊本來就以好用的內部工具為傲,後台那章細講)。對只有 3 個後端的團隊,admin 等於免費多了一層「不會手滑」的維運介面。第二個理由是 Celery:配上 RabbitMQ 和 heartbeat 排程,你就有了一套類似 Airflow 的能力,但完全不用管 Airflow 的維運。抓留言、批次下單、發票、對帳 job 全跑在上面。工作流平台是好東西,但它有自己的伺服器要養、自己的坑要踩——在每天十幾個 feature 的節奏裡,「不用管維運」本身就是最大的 feature。
小團隊的複雜度預算是固定的:你在 infra 上花掉一點,業務上就少一點。當年這套選擇的高明之處(老實說有一半是運氣),是把預算幾乎全留給了業務——留言解析的 FSM、庫存的不變量、金流的冪等,這些才是這個產品的難點。infra 全選最無聊的:每個元件都成熟到不會半夜給你驚喜,文件多到外包工程師進來一週就能動手。先痛過,才知道工具在解什麼——反過來也成立:還沒痛過的地方,先不要買解藥。
但我必須把另一面也講出來:這章講的「快」,是用「穩」欠債換的。上線初期 API server 只開一台 process、單一 CPU,直播一開就被打爆,緊急上 traefik 開了四個行程才扛住;那個年代團隊裡沒有 SRE 這個角色,所有 infrastructure 都是我這個 backend lead 兼著扛,每場直播人肉跟播、提心吊膽。CI/CD 讓我們把 feature 送上線送得飛快——但上線之後會發生什麼,當年幾乎是裸奔。這筆帳我留到維運那章算,這裡先記一句:起手式決定你跑多快,跑得久不久,是另一門功課。
本文改寫自我的部落格系列《Re:從零開始做直播代購電商平台》,本篇完整版:https://blog.aidan.tw/blog/rezero-stack/


 iThome鐵人賽
 看影片追技術